SEO
Les moteurs de recherche et les aperçus de liens (Slack, X, LinkedIn, WhatsApp...) lisent le titre et les balises meta d'une page avant tout le reste. Luna Park vous permet de les définir pour tout le site et pour chaque page, y compris les pages dont le contenu vient de la base de données, comme /blog/:slug.
Le backend de l'application exportée écrit ces balises dans le HTML de chaque page : elles sont présentes même pour les robots qui n'exécutent pas JavaScript. Il sert aussi /sitemap.xml et /robots.txt.
Prérequis
- Le mode d'historique doit être Web Mode, le mode par défaut des nouveaux projets : en Hash Mode, toutes les pages partagent la même URL pour les moteurs de recherche.
- Les pages doivent être servies par le backend de l'application exportée (voir Auto-hébergement). Sur un hébergeur statique, seuls les réglages du site ci-dessous sont écrits dans le HTML ; les réglages des pages sont appliqués dans le navigateur.
Réglages du site
Ouvrez la section SEO du workspace Settings :
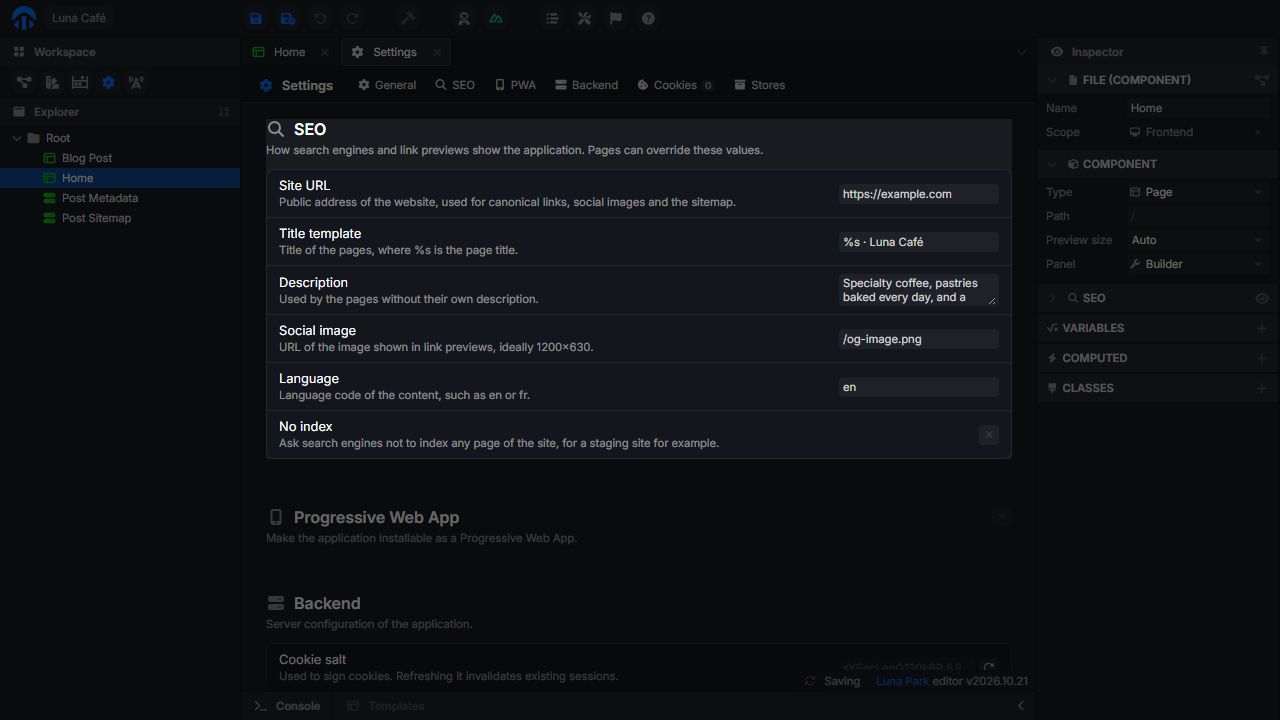
| Réglage | Par défaut | Description |
|---|---|---|
| Site URL | Vide | L'adresse publique du site, comme https://example.com. Utilisée pour les liens canoniques, les URL absolues des images et le sitemap. |
| Title template | %s | Le titre des pages, où %s est le titre de la page. Par exemple %s · Luna Café. Les pages sans titre utilisent le nom de l'application. |
| Description | Vide | La description des pages qui n'ont pas la leur. |
| Social image | Vide | L'image affichée dans les aperçus de liens, idéalement en 1200×630. Un chemin commençant par / est complété avec l'URL du site. |
| Language | en | La langue du contenu, placée sur la balise <html>. |
| No index | Désactivé | Demande aux moteurs de recherche de n'indexer aucune page, pour un site de préproduction par exemple. robots.txt interdit alors tout le site. |
Réglages d'une page
Sélectionnez une page et ouvrez le panneau SEO de l'inspecteur. Il définit le titre, la description et l'image de cette page ; les champs vides reprennent les réglages du site.
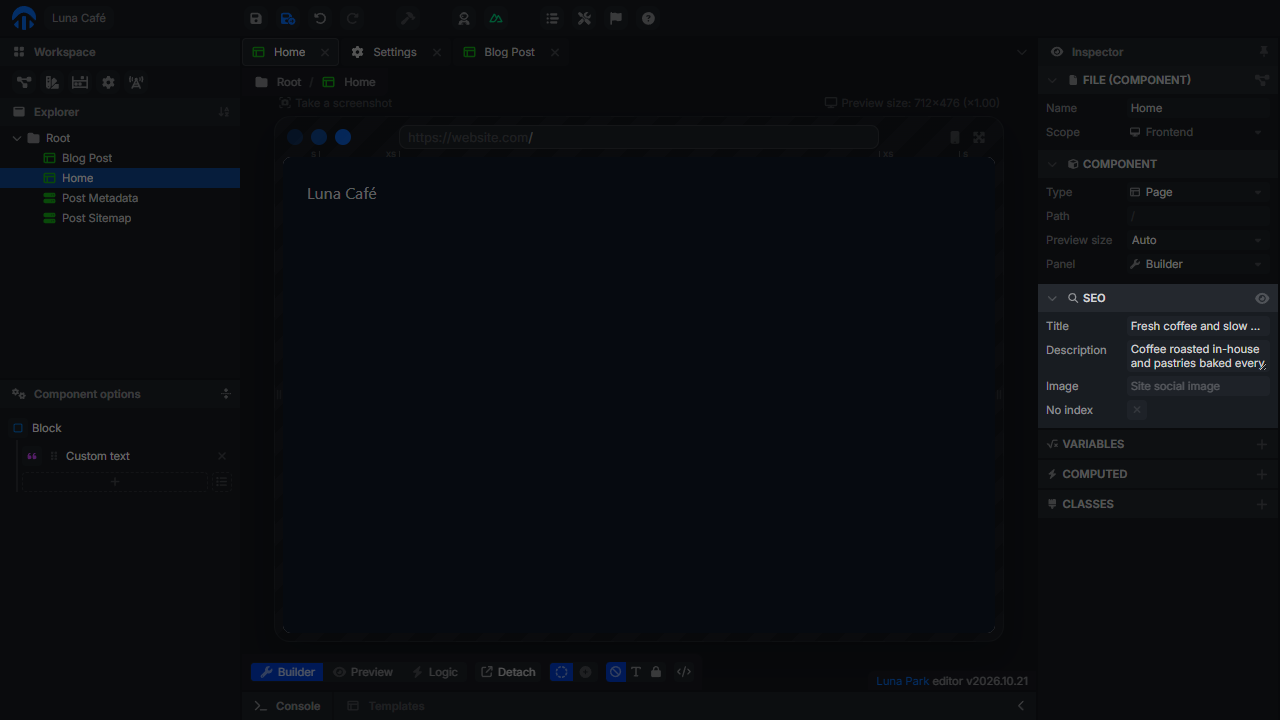
| Champ | Description |
|---|---|
| Title | Le titre de la page, inséré dans le modèle de titre. |
| Description | La description affichée sous le titre dans les résultats de recherche. |
| Image | L'image des aperçus de liens pour cette page. |
| No index | Demande aux moteurs de recherche de ne pas indexer cette page. Elle reste accessible, mais n'apparaît ni dans les résultats de recherche ni dans le sitemap. |
Aperçu Google
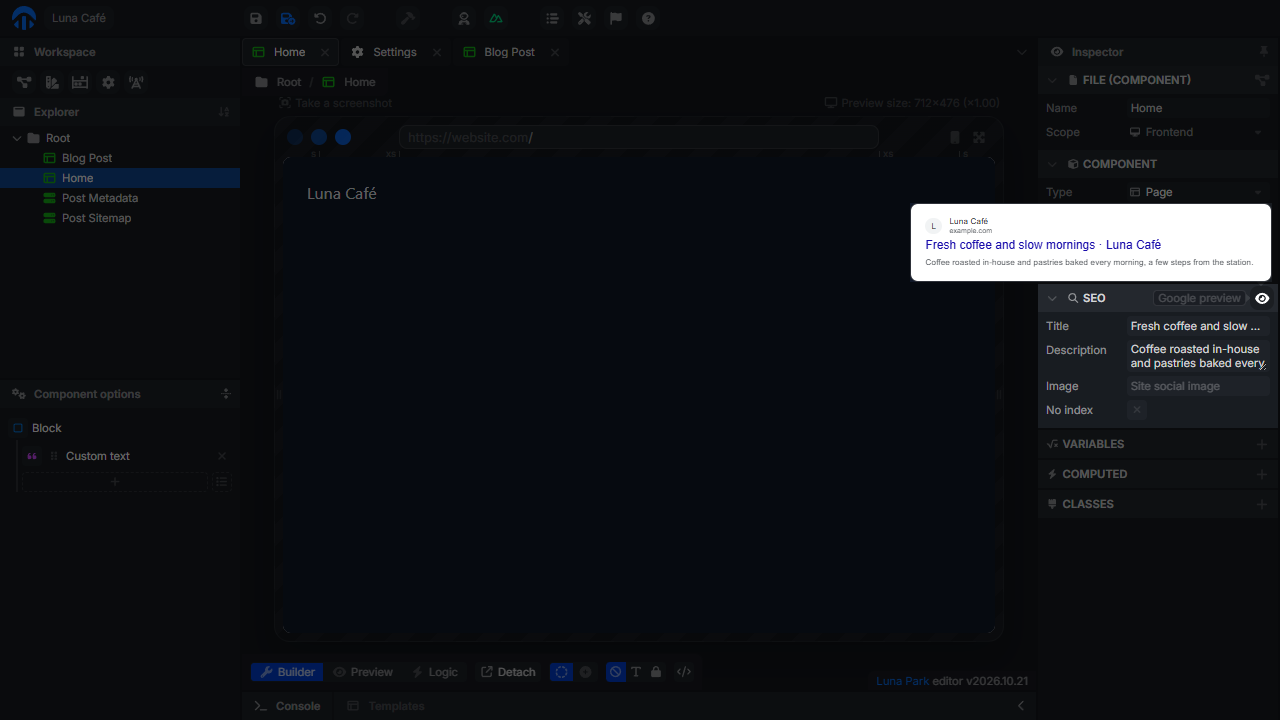
Cliquez sur le bouton du panneau pour voir comment la page pourrait apparaître dans les résultats de Google, avec le modèle de titre, l'URL du site et la description.
Pages dynamiques
Une page avec un segment dynamique, comme /blog/:slug, affiche un article par URL : un titre fixe serait le même pour tous les articles. Son panneau SEO propose un choix de Source :
- Static : le même titre, la même description et la même image pour toutes les URL, comme ci-dessus.
- Dynamic : les balises viennent d'une route de votre backend.
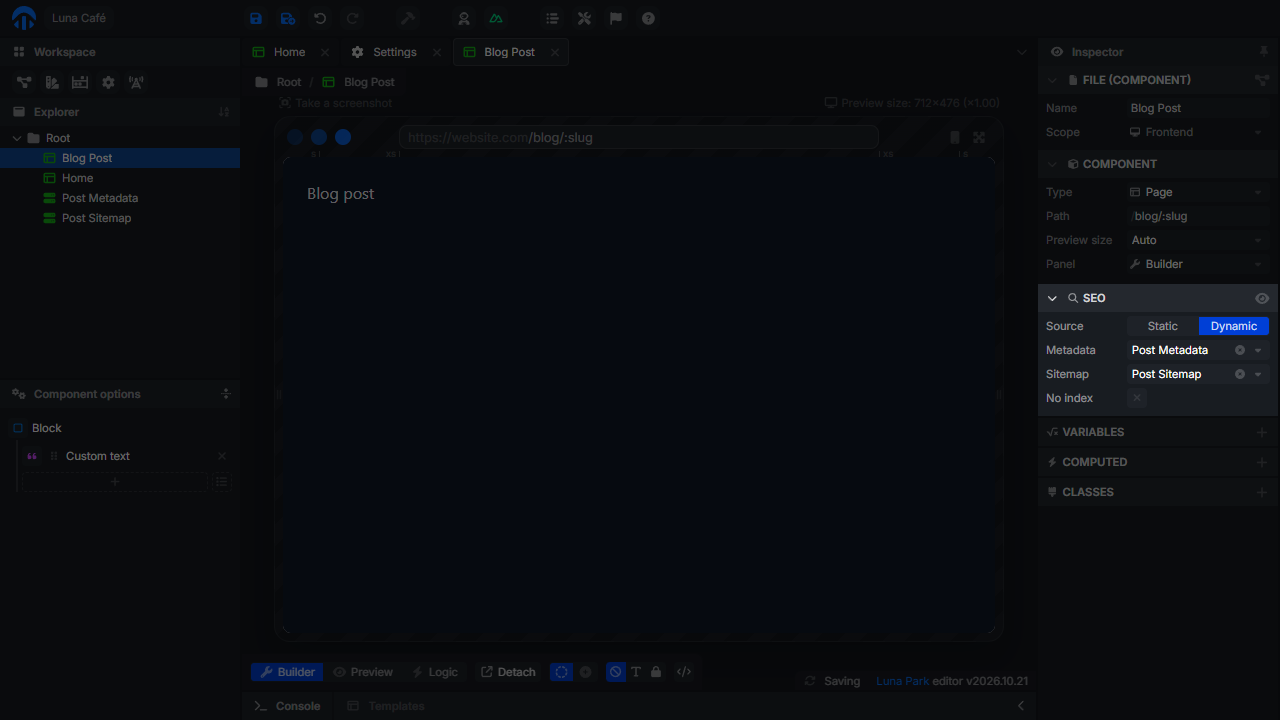
Les deux listes proposent les routes GET du projet. Choisissez New route en bas de la liste pour en créer une à côté de la page : pour Metadata, sa query contient déjà les paramètres du chemin de la page.
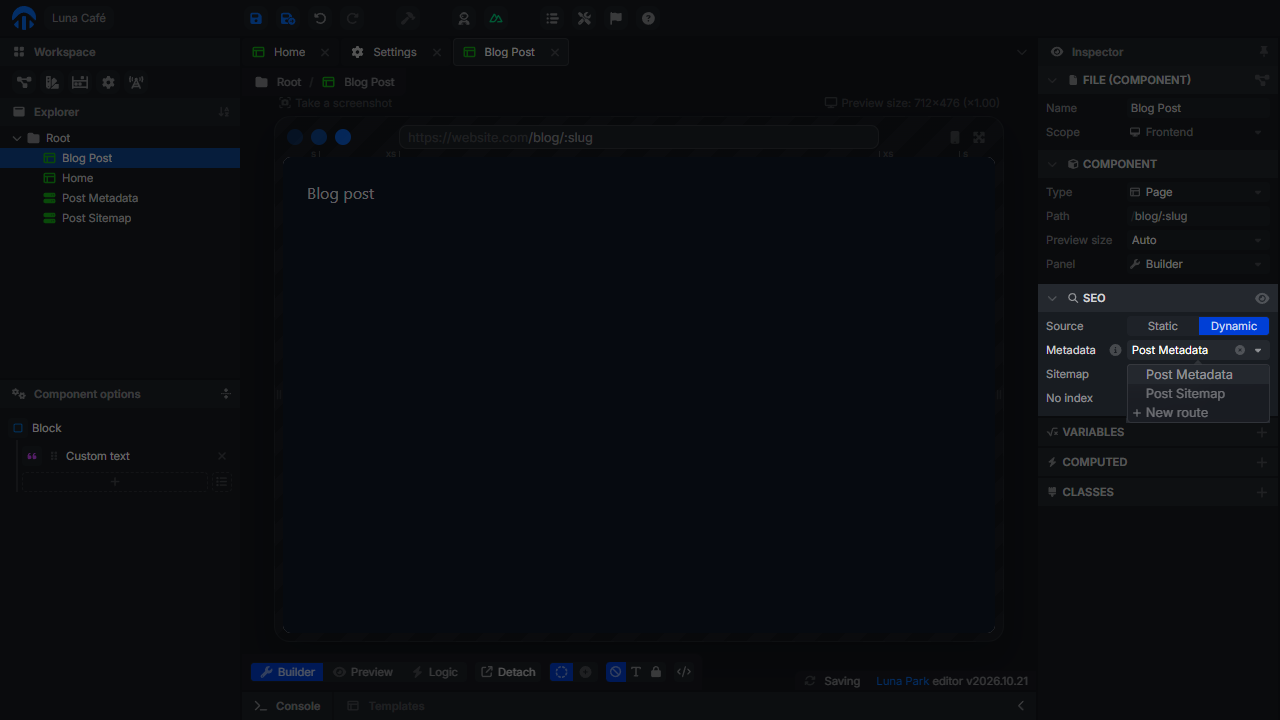
Route de métadonnées
La route Metadata renvoie les balises d'une URL. Elle reçoit les paramètres du chemin de la page, comme paramètres de chemin si le chemin de la route les déclare (/post-metadata/:slug) et comme paramètres de query (?slug=hello). Sa réponse est un objet avec tout ou partie de ces propriétés :
{
    "title": "Comment nous torréfions nos grains",
    "description": "Du grain vert à votre tasse, en cinq étapes.",
    "image": "/covers/roasting.png",
    "noindex": false
}
Les propriétés absentes gardent les réglages du site. Quand la route répond 404, la page répond aussi 404, avec noindex : un article supprimé disparaît des résultats de recherche. Toute autre erreur garde les réglages du site.
Quand le backend construit le HTML, il appelle la route sans les cookies du visiteur : une route protégée par un garde qui exige un utilisateur connecté y échoue. Ne renvoyez que des données publiques.
Route du sitemap
La route Sitemap liste les URL de la page pour /sitemap.xml. Elle renvoie un tableau avec une entrée par URL : un objet avec une propriété par paramètre, ou une simple valeur quand le chemin n'a qu'un paramètre.
[{ "slug": "nos-nouvelles-patisseries" }, { "slug": "comment-nous-torrefions-nos-grains" }]Sans route de sitemap, une page dynamique n'apparaît pas dans le sitemap.
Ce que sert l'application exportée
Le backend répond à chaque URL de page avec le HTML de l'application, et remplit son <head> :
<title>Comment nous torréfions nos grains · Luna Café</title>
<meta name="description" content="Du grain vert à votre tasse, en cinq étapes.">
<link rel="canonical" href="https://example.com/blog/comment-nous-torrefions-nos-grains">
<meta property="og:type" content="website">
<meta property="og:site_name" content="Luna Café">
<meta property="og:title" content="Comment nous torréfions nos grains · Luna Café">
<meta property="og:description" content="Du grain vert à votre tasse, en cinq étapes.">
<meta property="og:url" content="https://example.com/blog/comment-nous-torrefions-nos-grains">
<meta property="og:image" content="https://example.com/covers/roasting.png">
<meta name="twitter:card" content="summary_large_image">- Le lien canonique et
og:urlnécessitent une Site URL, et sont omis sur les pages en No index. - Une URL qui ne correspond à aucune page répond 404 avec
noindex. Les routes/apiinconnues et les fichiers manquants gardent leur 404 en JSON. - Le HTML des pages n'est jamais mis en cache, tandis que les ressources gardent leur cache long.
/sitemap.xmlliste les pages sans segment dynamique, plus les URL de chaque route de sitemap, sauf les pages en No index./robots.txtautorise tout le site et indique le sitemap, ou interdit tout quand le site est en No index.
Dans le navigateur, le titre et les balises suivent la navigation entre les pages, en appelant la route de métadonnées des pages dynamiques.
Vérifier vos balises
Ouvrez une URL de page de l'application déployée avec Afficher le code source de la page, ou collez-la dans l'aperçu de lien d'une messagerie, pour voir les balises que reçoivent les robots.
Le contenu des pages reste rendu dans le navigateur. Google exécute JavaScript et l'indexe ; les robots qui ne l'exécutent pas ne voient que les balises.